Карта → событие
Лемма Джонсона — Линденштрауса: размерность, которой можно пренебречь
Проклятие размерности
Задача, которую к 1980-м умели ставить, но не умели решать: есть миллион объектов, каждый описан тысячей признаков — и надо находить среди них похожие.
Формально объекты — точки в пространстве размерности $d=1000$, похожесть — близость. Беда в том, что в пространствах высокой размерности геометрия ведёт себя враждебно: объём сосредоточен у границы, все расстояния между случайными точками почти одинаковы, а структуры данных для поиска ближайшего соседа вырождаются в полный перебор. Это называют проклятием размерности, и до 1980-х оно считалось непреодолимым.
Естественная мысль — сжать описание, выбросив лишние признаки. Но какие лишние? И не испортим ли мы расстояния, ради которых всё затевалось?
Лемма
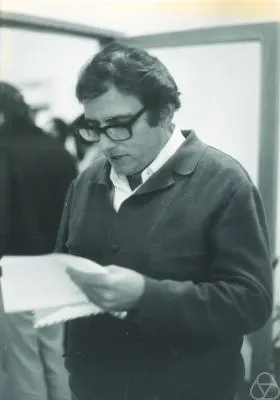
В 1984 году Уильям Джонсон и Йорам Линденштраус доказывают утверждение, занимающее в статье страницу и служащее там техническим средством для совсем другой цели — продолжения липшицевых отображений, вопроса из теории банаховых пространств той самой школы, что выросла из львовского кафе.
Лемма. Пусть даны $n$ точек в евклидовом пространстве любой размерности и число $\varepsilon>0$. Тогда существует линейное отображение в пространство размерности
$$k=O\!\left(\frac{\log n}{\varepsilon^{2}}\right),$$
сохраняющее все попарные расстояния с точностью до множителя $1\pm\varepsilon$.
Прочтём внимательно, потому что здесь легко проскочить главное.
Целевая размерность $k$ не зависит от исходной размерности $d$ вообще. Ни при каком $d$ — тысяча, миллион, миллиард — она не изменится. Она зависит только от числа точек, и то логарифмически.
Миллион точек, описанных миллионом признаков, укладывается в пространство размерности порядка сотни — и все расстояния между ними при этом сохраняются с точностью в несколько процентов.
Как это может быть
Отображение, которое годится, — случайная проекция: просто спроецировать на случайно выбранное подпространство нужной размерности (и умножить на масштабный множитель).
Механизм — концентрация меры. Длина проекции фиксированного вектора на случайное $k$-мерное подпространство есть случайная величина, и при растущем $k$ она сосредоточена около своего среднего плотнее любых ожиданий: вероятность отклониться от него больше чем на $\varepsilon$ убывает как $e^{-k\varepsilon^{2}}$. Пар точек всего $C_{n}^{2}<n^{2}$; выбрав $k$ порядка $\log n/\varepsilon^{2}$, мы делаем вероятность испортить хоть одну пару меньше единицы — а значит, годная проекция существует.
Более того, случайная проекция годится почти наверняка: не нужно её искать, достаточно взять любую наудачу и проверить. Доказательство существования оказывается рецептом.
Пятнадцать лет спустя
Джонсон и Линденштраус доказывали теорему функционального анализа и о применениях не думали. Прикладную жизнь лемма получила в конце 1990-х, когда понадобилось искать похожие документы, изображения и профили: на ней стоит хеширование с учётом близости (Индик и Мотвани, 1998), снижение размерности признаков в машинном обучении, сжатые измерения.
Для нашей линии здесь очередная смена дефицита. Всё, что было раньше, экономило операции или память. Здесь экономят размерность — и оказывается, что заплатить за это можно точностью, причём по известной цене: хотите вдвое точнее — платите вчетверо большей размерностью, вот формула.
Следующая точка: Мюррей-Хилл — где выяснится, что цена вычисления зависит от того, из чего сделана машина.